01
Aprender →
Lições progressivas para construir os conceitos.
Opções de acessibilidade
Remova os elementos decorativos sem ocultar textos ou ilustrações didáticas. Você também pode ampliar a página pelo navegador.
Limitar movimentos e transições. A preferência do dispositivo tem prioridade.
ENTENDER · EXPERIMENTAR · VERIFICAR
Do primeiro token aos mecanismos que constroem uma resposta.
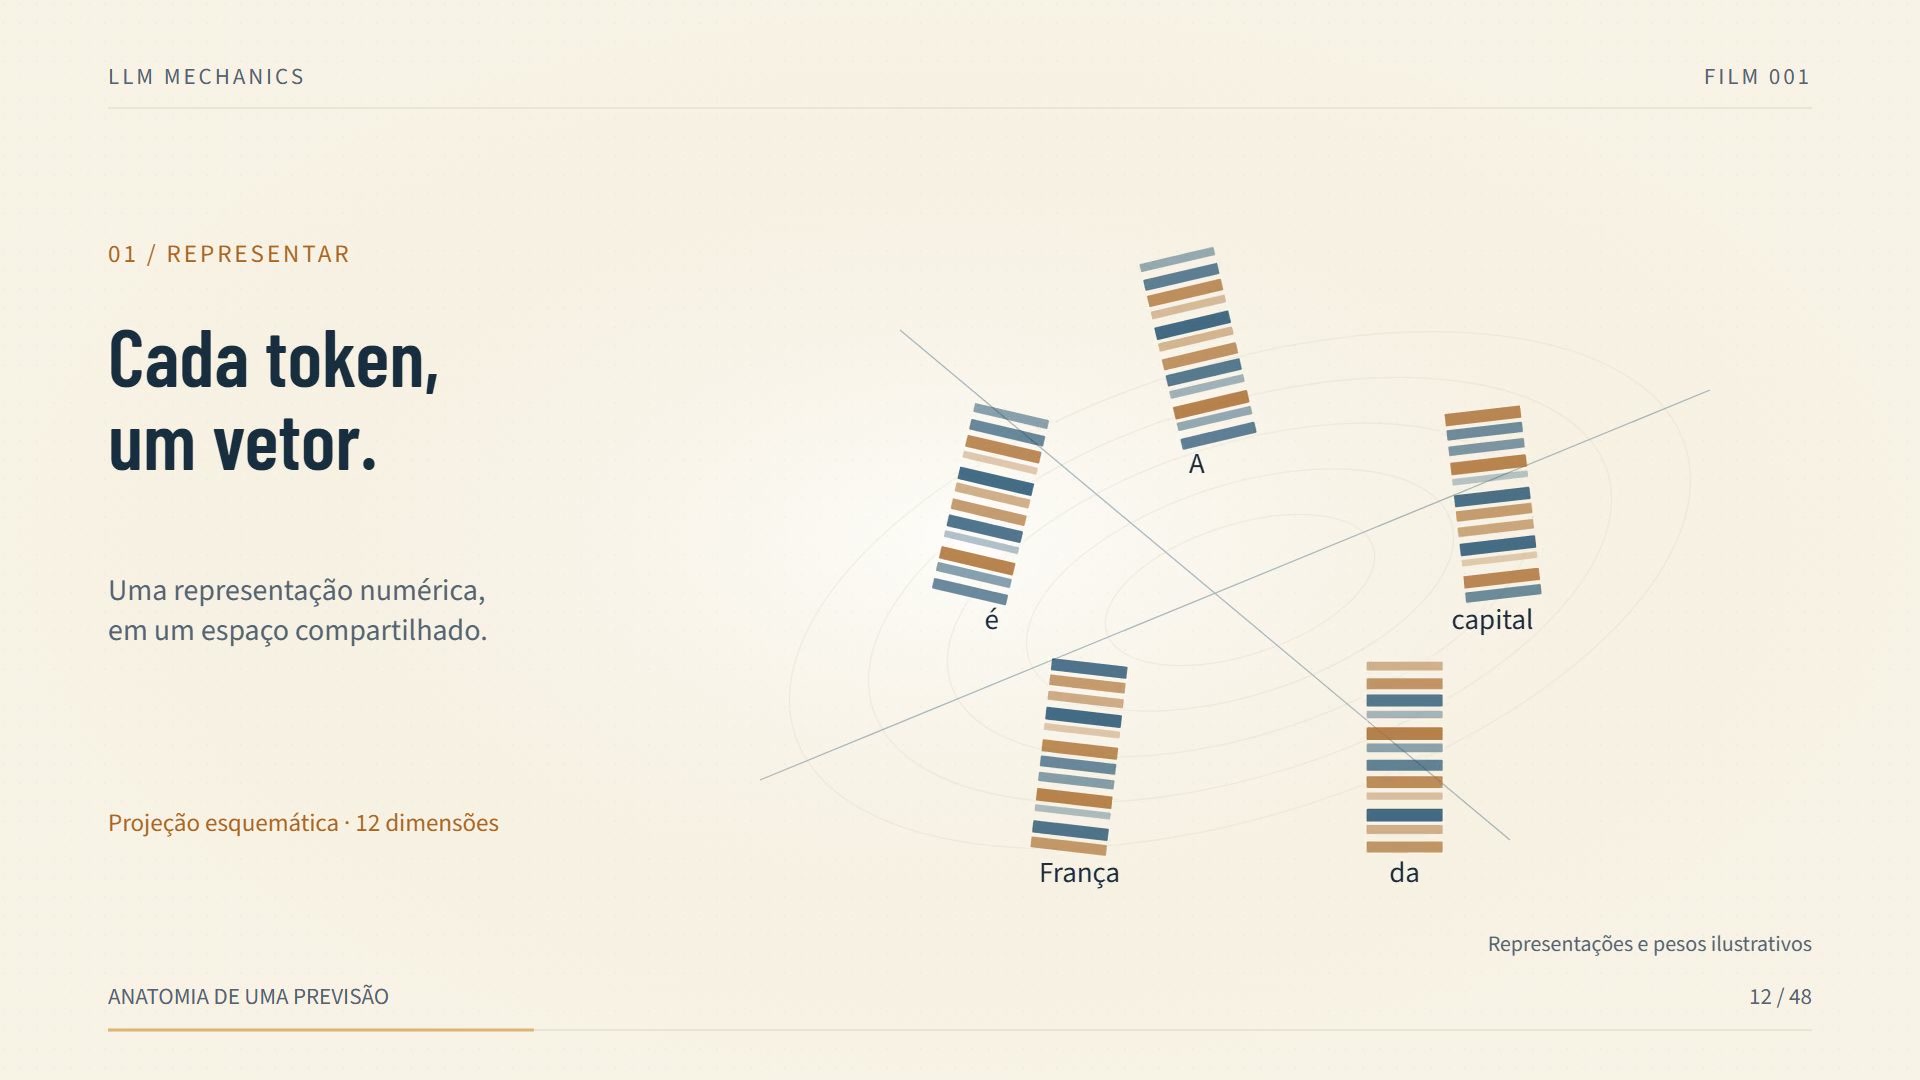
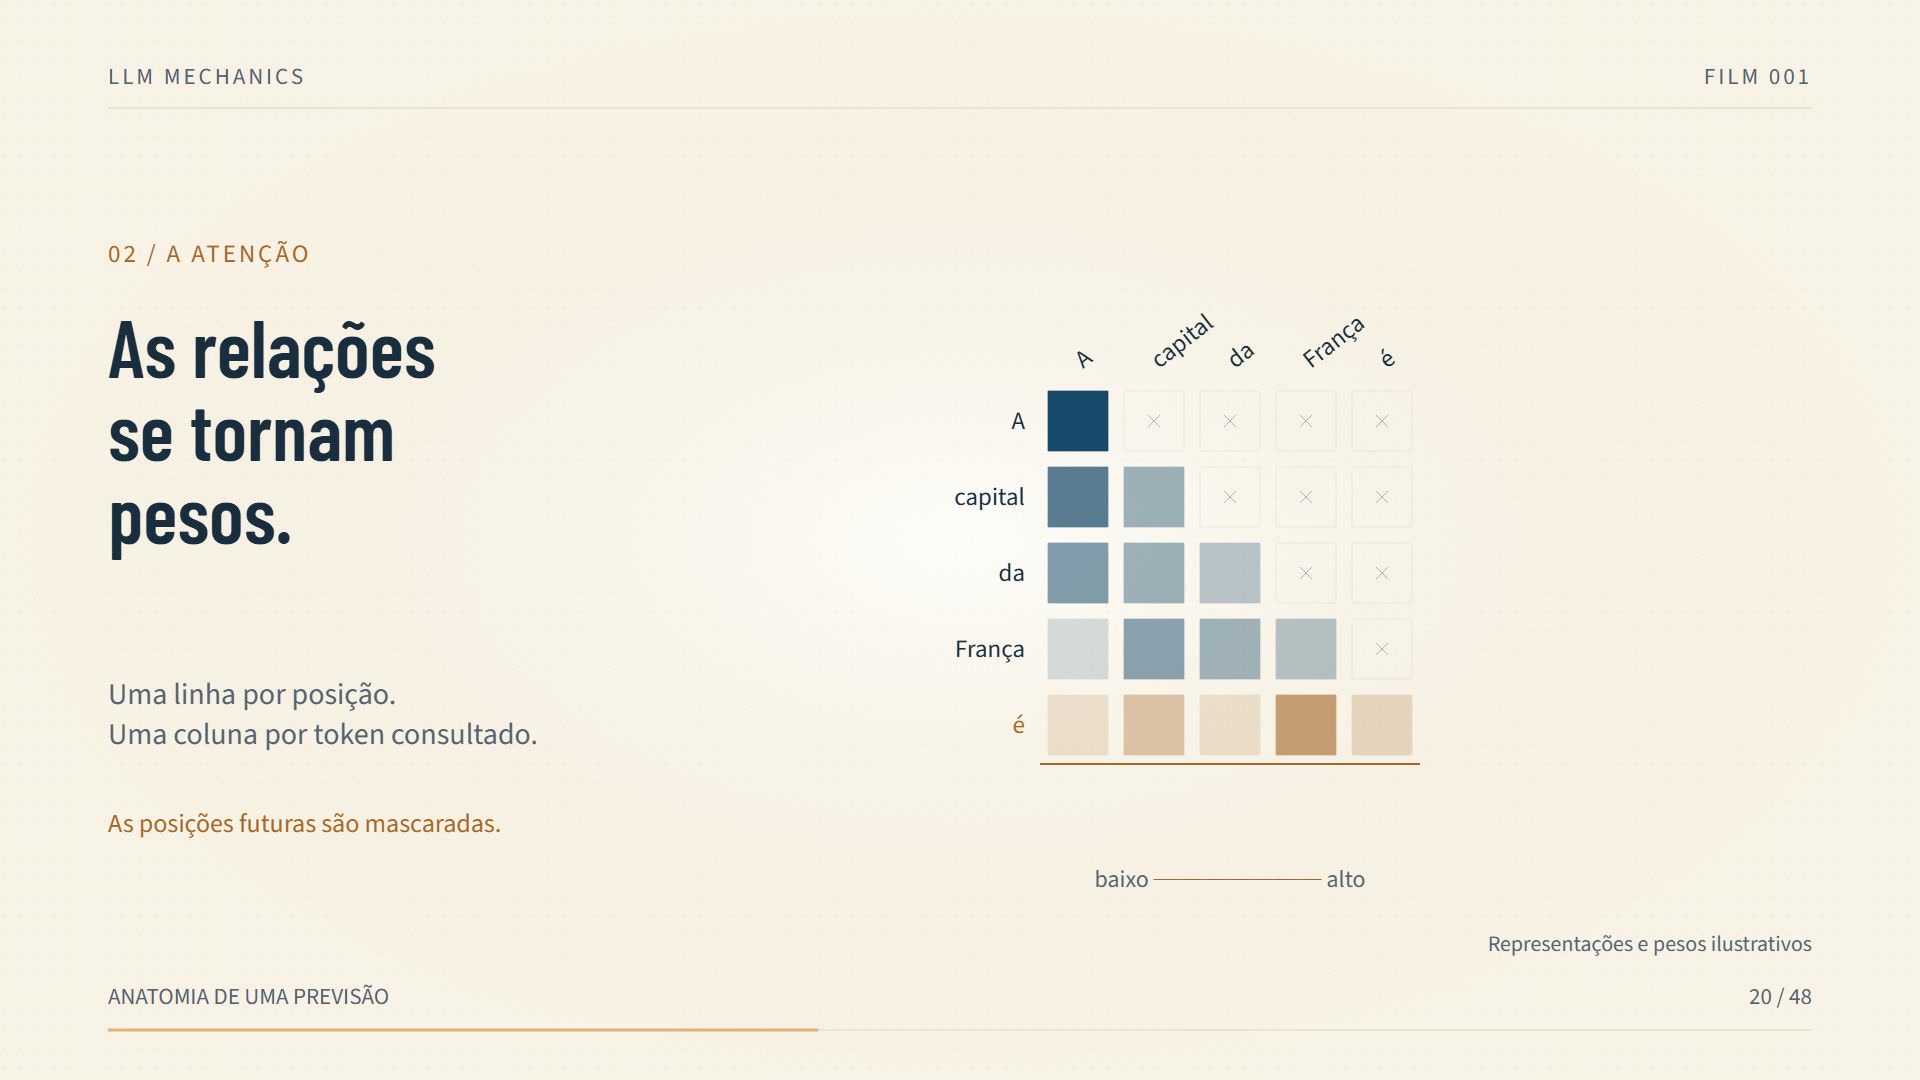
Acompanhe uma frase: tokens, vetores, atenção, camadas do Transformer e escolha do próximo token.
Do texto aos números. A frase “A capital da França é” se divide em cinco palavras, tratadas aqui como tokens. Cada token se torna um vetor; doze dimensões são ilustradas em um espaço esquemático.
Das relações ao contexto. As conexões entre posições se tornam uma matriz de pesos de atenção. Cada linha consulta as posições anteriores e a sua própria posição. As posições futuras são mascaradas.
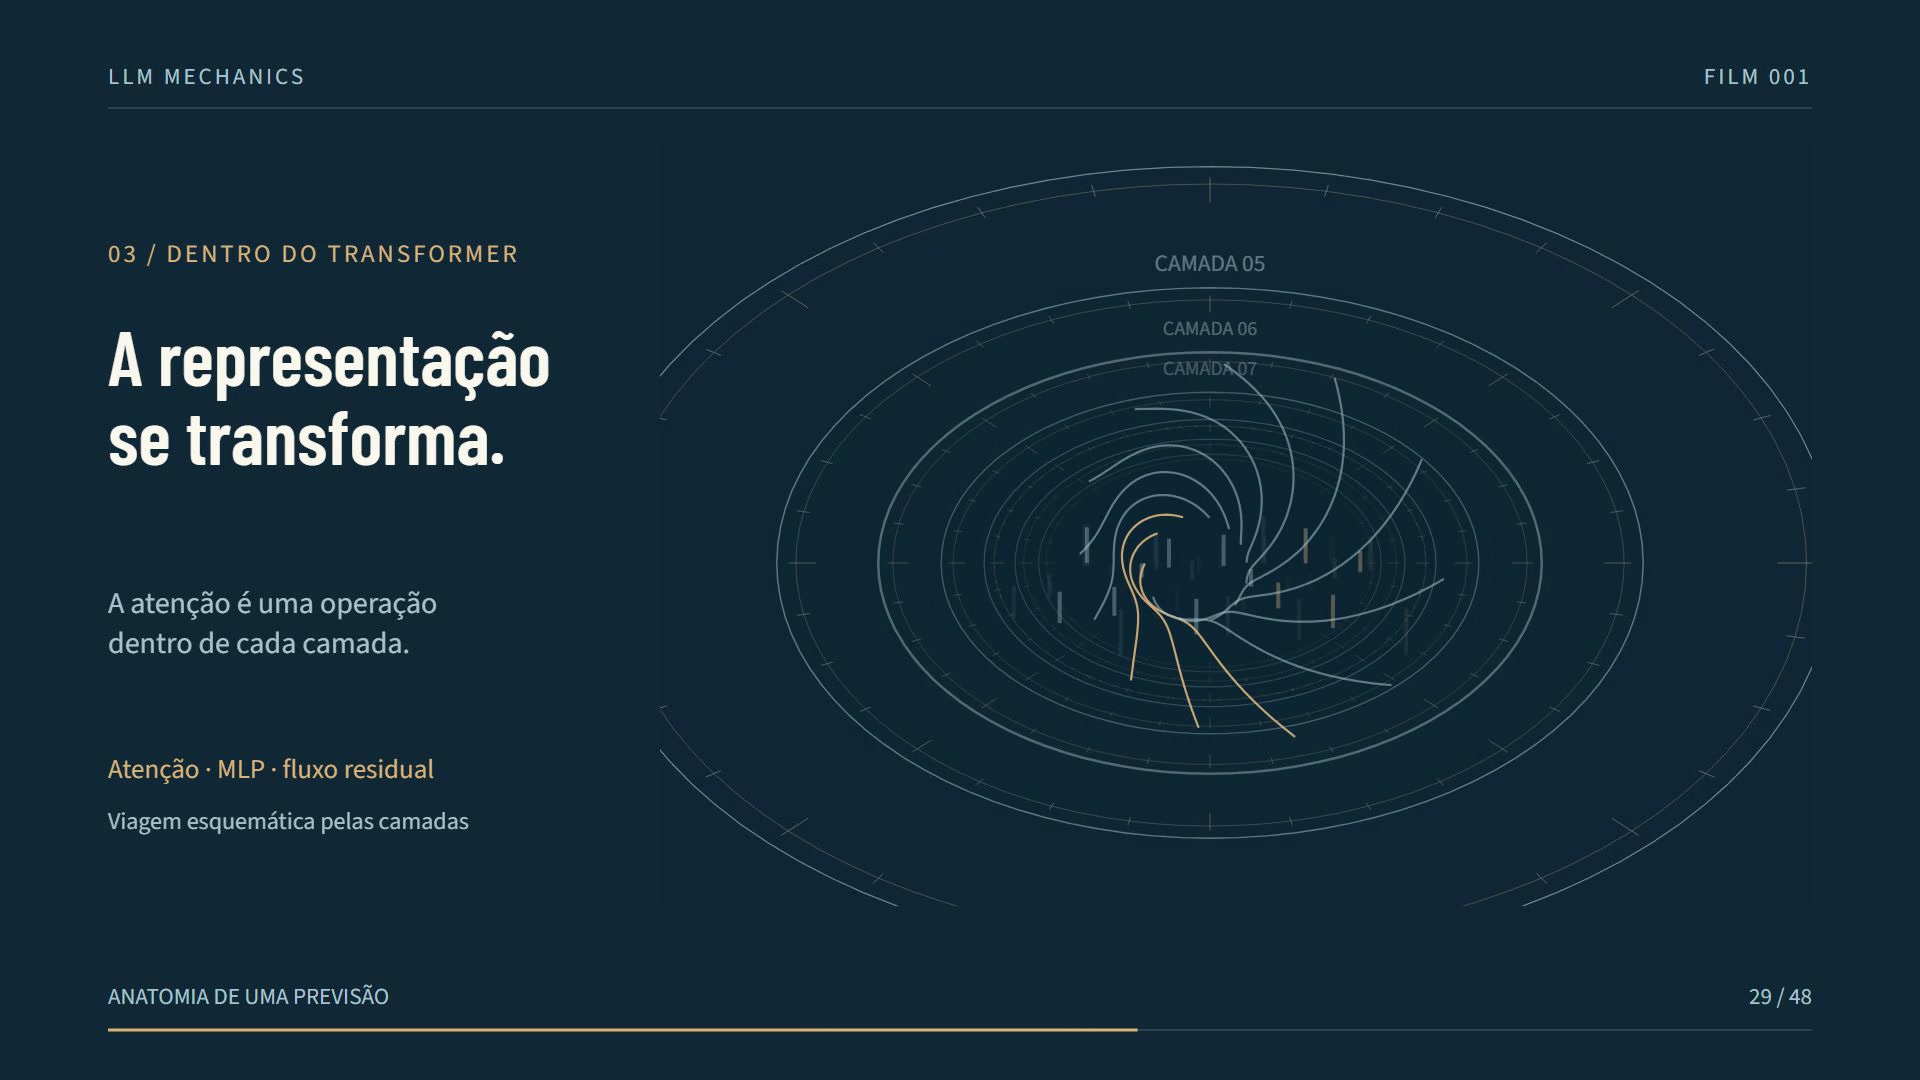
Pelas camadas. A representação atravessa as camadas do Transformer. A atenção, o MLP e o fluxo residual contribuem para sua transformação. O percurso pelas camadas é esquemático.
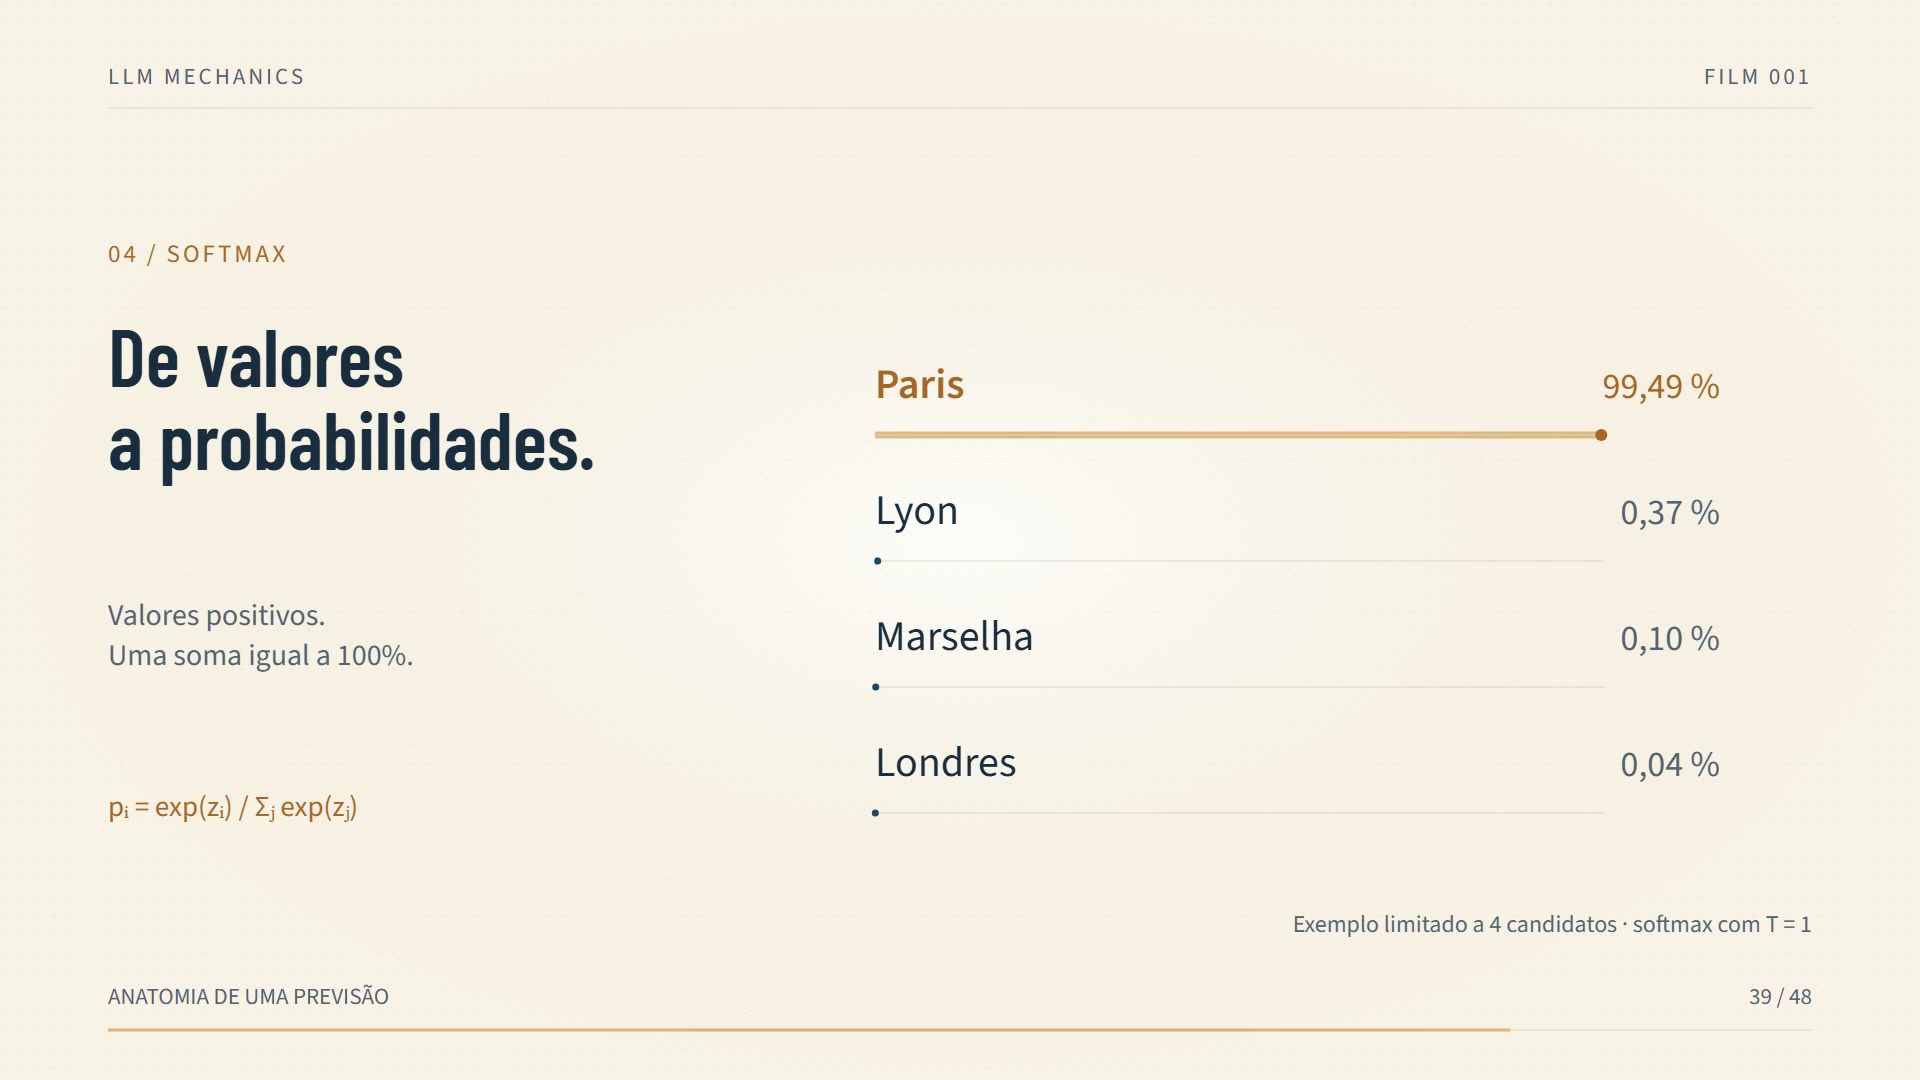
Do valor ao próximo token. A última posição produz logits para quatro candidatos: Paris 8,7; Lyon 3,1; Marselha 1,8; Londres 0,9. Softmax, com temperatura 1, converte esses valores em probabilidades que somam 100%. Paris recebe cerca de 99,49% neste exemplo reduzido. O token mais provável se junta à frase: “A capital da França é Paris”. O processo pode se repetir.
Ilustração educativa: divisão simplificada em palavras, vetores e pesos fictícios. As probabilidades são calculadas sobre quatro candidatos, não sobre todo o vocabulário de um modelo. O vídeo escolhe o máximo; um modelo também pode fazer amostragem.
01
Lições progressivas para construir os conceitos.
02
Experimentos guiados para testar uma ideia.
03
Análises duradouras para aprofundar.
04
As novidades da IA e seus usos.
Explicações visuais e progressivas.
Experiências e efeitos para observar.
Situações concretas e resultados para verificar.
Dois livros para aprofundar.
Entender a máquina. Depois, aprender a investigá-la.
VOLUME I / ENTENDER
Da linguagem às arquiteturas e aplicações: construir uma compreensão sólida do que faz um LLM.
VOLUME II / INVESTIGAR
Ir além das aparências: medir, inspecionar e intervir para examinar o que os resultados permitem concluir.
Aprender
Como uma frase se transforma em uma proposta de resposta? Selecione uma etapa para acompanhar o cálculo.
Você escreve “A capital da França é”. O modelo recebe esse contexto e propõe a continuação. Ele não escolhe uma resposta inteira de uma vez: aqui examinamos um único passo de geração.
Diagrama didático: divisão, vetores, pesos e probabilidades ilustrativos. Nenhum modelo é executado.
Aprender
Lições guiadas conectam conceitos, experiências do Lab e capítulos dos dois livros. Comece com uma situação concreta, construa o raciocínio e depois verifique-o.
Antes de qualquer multiplicação de matrizes, o texto vira uma sequência de identificadores. Teste um tokenizador BPE e veja o efeito sobre o custo.
Ler a lição : Dividir o texto em tokens determina o custo e a latência →Os embeddings colocam as palavras em um espaço onde as relações viram translações. Manipule-os em um observatório 3D.
Ler a lição : A geometria do espaço latente transforma sentido em vetores →Consultas, chaves e valores: veja como cada token interroga os demais e por que se divide por √d_k antes do softmax.
Ler a lição : A atenção multicabeça liga cada palavra ao contexto em paralelo →Em vez de somar uma posição, o RoPE faz girar Consultas e Chaves. Teste em um mostrador por que só a diferença importa.
Ler a lição : O RoPE codifica a distância relativa por uma rotação geométrica →Um roteador ativa apenas alguns especialistas por token. Simule o roteamento Top-K e o colapso, e distinga parâmetros totais e ativos.
Ler a lição : O Mixture of Experts especializa o cálculo sem pesar na inferência →O verdadeiro gargalo é a memória, não o cálculo. Compare os fluxos HBM e SRAM e depois estime a VRAM de um modelo com um dimensionador.
Ler a lição : FlashAttention e o cache KV domam a hierarquia de memória da GPU →Entenda como representações, circuitos e intervenções causais ajudam a investigar um LLM — e o que esses métodos ainda não demonstram.
Ler a lição : Interpretabilidade mecanicista de LLMs: guia prático →Uma informação visível dentro do modelo é realmente usada? Construa um contraste, meça uma restauração e aprenda a testar uma explicação.
Ler a lição : A oficina dos LLM: substituir uma ativação para compreender →Acompanhe uma solicitação em cinco verificações: intenção, extração, evidência, geração e avaliação.
Ler a lição : Da pergunta à resposta verificável →O laboratório / 01—05
Imagine um assistente atendendo solicitações de clientes. Em cada etapa, uma resposta plausível pode esconder um erro. Estas cinco experiências ensinam a construir verificações úteis.
Distinguir o sucesso em um conjunto de dados da capacidade de reconhecer o problema relevante.
Entender por que formato utilizável e informação correta são exigências distintas.
Distinguir um documento aparentemente pertinente de evidência suficiente para uma situação específica.
Distinguir a probabilidade de escolher um token da probabilidade de uma resposta ser verdadeira.
Interpretar precisão pela perspectiva dos alertas recebidos e revocação pela dos incidentes reais.
Artigos
Explicações detalhadas, exemplos e métodos para aprofundar suas experiências.
Um alerta desnecessário e um incidente perdido podem ter custos muito diferentes.
Ler o artigo →Construa um teste que diferencie uma habilidade útil de um atalho acidental.
Ler o artigo →O que a decodificação muda e o que ela não pode garantir.
Ler o artigo →Um JSON correto pode conter a informação errada. Um protocolo para separar formato e significado.
Ler o artigo →Notícias
Novos modelos, pesquisa e ferramentas: as novidades da inteligência artificial, como funcionam e para que servem.
Modelos
Publicado em
A Anthropic apresenta uma nova versão do Sonnet, destacando uma execução mais rápida e um consumo menor de tokens.
Ler a notícia : Claude Sonnet 5.5: Anthropic aposta na velocidade →Ferramentas e usos
Publicado em
Mozilla e Mistral anunciam uma parceria para o Smart Window, assistente de navegação do Firefox ainda em beta.
Ler a notícia : Mistral chega ao Firefox Smart Window →Métodos e arquiteturas
Publicado em
Uma retomada da arquitetura do Small 4: por que um modelo pode ter muitos especialistas sem ativar todos para cada token?
Ler a notícia : Mistral Small 4: como funciona uma mistura de especialistas →